Bạn đã có mô hình, đã có bảng hỏi — nhưng phát bao nhiêu phiếu là đủ? Ít quá thì EFA không đạt, hệ số không ổn định và giả thuyết “trượt” vì thiếu lực kiểm định; nhiều quá thì tốn thời gian, chi phí. Và gần như chắc chắn hội đồng sẽ hỏi: “Cỡ mẫu này em tính theo căn cứ nào?” Bài viết tổng hợp các công thức tính cỡ mẫu được trích dẫn nhiều nhất, khi nào dùng công thức nào, kèm ví dụ tính sẵn và đoạn văn mẫu để đưa vào luận văn.
- Vì sao cỡ mẫu quyết định kết quả?
- Chọn công thức nào cho đề tài của bạn?
- Cỡ mẫu cho EFA (Hair et al.)
- Cỡ mẫu cho hồi quy (Tabachnick & Fidell)
- Cỡ mẫu cho SEM / AMOS
- Cỡ mẫu cho PLS-SEM / SmartPLS
- Biết tổng thể: công thức Yamane (Slovin)
- Không biết tổng thể: công thức Cochran
- Chốt con số cuối cùng & viết vào luận văn
1Vì sao cỡ mẫu quyết định kết quả nghiên cứu?
Cỡ mẫu không chỉ là thủ tục để “điền vào chương 3”. Nó ảnh hưởng trực tiếp đến việc các phép kiểm định có phát hiện được mối quan hệ thật trong dữ liệu hay không (lực kiểm định — statistical power). Khi mẫu quá nhỏ, ba vấn đề thường xuất hiện cùng lúc:
- EFA không “ra” được cấu trúc: KMO thấp, biến tải lung tung giữa các nhân tố.
- Hệ số không ổn định: chạy lại với vài phiếu khác là β đổi dấu, đổi độ lớn.
- Giả thuyết không có ý nghĩa thống kê dù mối quan hệ có thật, chỉ vì sai số chuẩn quá lớn.
Cỡ mẫu được xác định theo phương pháp phân tích bạn dùng. Một đề tài dùng cả EFA và hồi quy phải thỏa yêu cầu của cả hai — và lấy con số lớn hơn.
2Chọn công thức tính cỡ mẫu nào cho đề tài của bạn?
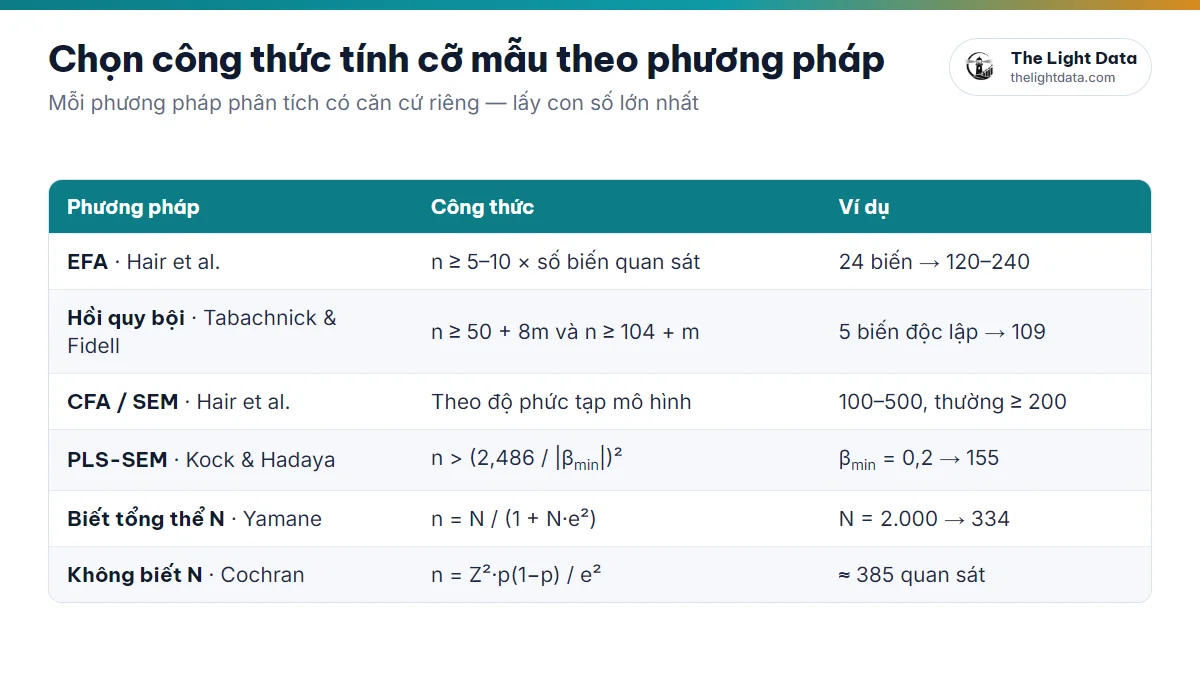
Trả lời hai câu hỏi: bạn có biết quy mô tổng thể không, và phương pháp phân tích chính là gì.
| Tình huống | Công thức nên dùng |
|---|---|
| Có chạy EFA (SPSS) | Hair et al.: n ≥ 5 × số biến quan sát |
| Hồi quy tuyến tính bội | Tabachnick & Fidell: n ≥ 50 + 8m |
| CFA / SEM bằng AMOS | Theo độ phức tạp mô hình (Hair et al., 2019) |
| PLS-SEM bằng SmartPLS | Căn bậc hai nghịch đảo (Kock & Hadaya, 2018) |
| Biết tổng thể N (VD: 2.000 sinh viên của khoa) | Yamane / Slovin |
| Tổng thể rất lớn hoặc không xác định | Cochran |
3Cỡ mẫu cho phân tích nhân tố khám phá EFA
Theo Hair, Black, Babin & Anderson (2019), mẫu cho phân tích nhân tố cần tối thiểu 50 quan sát, tốt hơn là từ 100 trở lên, và tỷ lệ quan sát trên mỗi biến đo lường tối thiểu là 5:1, tốt hơn là 10:1.
Mô hình có 6 nhân tố, mỗi nhân tố 4 biến quan sát → 24 biến.
- Tỷ lệ 5:1 → n ≥ 24 × 5 = 120
- Tỷ lệ 10:1 → n ≥ 24 × 10 = 240
Đếm tất cả biến quan sát đưa vào EFA, kể cả biến phụ thuộc nếu bạn chạy chung. Câu hỏi nhân khẩu học không tính.
4Cỡ mẫu cho hồi quy tuyến tính bội
Tabachnick & Fidell (2013) đưa ra hai công thức, với m là số biến độc lập:
- n ≥ 50 + 8m — để kiểm định mô hình hồi quy tổng thể (R²).
- n ≥ 104 + m — để kiểm định từng hệ số hồi quy riêng lẻ.
Mô hình có 5 biến độc lập: 50 + 8 × 5 = 90 và 104 + 5 = 109 → chọn tối thiểu 109 quan sát.
5Cỡ mẫu cho CFA và SEM bằng AMOS
CB-SEM (AMOS) “đói mẫu” hơn hồi quy vì ước lượng đồng thời nhiều tham số. Hair et al. (2019) đề xuất cỡ mẫu tối thiểu theo độ phức tạp của mô hình:
| Đặc điểm mô hình | Cỡ mẫu tối thiểu |
|---|---|
| ≤ 5 nhân tố, mỗi nhân tố trên 3 biến, communality cao (≥ 0,6) | 100 |
| ≤ 7 nhân tố, communality vừa phải (≈ 0,5) | 150 |
| ≤ 7 nhân tố, communality thấp (< 0,45) hoặc có nhân tố ít hơn 3 biến | 300 |
| Nhiều nhân tố, communality thấp | 500 |
Trên thực tế, các nghiên cứu dùng SEM thường hướng tới từ 200 quan sát trở lên để chỉ số Model Fit ổn định.
6Cỡ mẫu cho PLS-SEM / SmartPLS
PLS-SEM linh hoạt hơn với mẫu nhỏ — nhưng “linh hoạt” không có nghĩa là “bao nhiêu cũng được”.
Quy tắc 10 lần (10-times rule)
Cỡ mẫu ≥ 10 × số mũi tên lớn nhất trỏ vào một biến tiềm ẩn bất kỳ (Barclay et al., 1995). Dễ tính nhưng Hair et al. (2022) cảnh báo quy tắc này thường đánh giá thấp cỡ mẫu cần thiết.
Phương pháp căn bậc hai nghịch đảo (khuyến nghị)
Kock & Hadaya (2018), được Hair et al. (2022) khuyến nghị, ở mức ý nghĩa 5%:
nmin > (2,486 / |βmin|)² — trong đó βmin là hệ số đường dẫn nhỏ nhất bạn kỳ vọng có ý nghĩa (lấy từ các nghiên cứu trước).
- βmin = 0,2 → (2,486 / 0,2)² = 154,5 → 155 quan sát
- βmin = 0,15 → (2,486 / 0,15)² = 274,7 → 275 quan sát
Ngoài ra có thể dùng G*Power (phân tích lực kiểm định cho hồi quy bội) với số biến dự báo lớn nhất trỏ vào một biến, power 0,80 và effect size f² = 0,15.
7Biết quy mô tổng thể: công thức Yamane (Slovin)
Khi tổng thể xác định được (VD: toàn bộ sinh viên một khoa, nhân viên một công ty), dùng công thức Yamane (1967) — một số tài liệu gọi là công thức Slovin:
n = N / (1 + N × e²) — N là quy mô tổng thể, e là sai số cho phép (thường 0,05).
Tổng thể 2.000 sinh viên, e = 0,05: n = 2.000 / (1 + 2.000 × 0,0025) = 2.000 / 6 = 333,3 → 334 sinh viên.
8Không biết quy mô tổng thể: công thức Cochran
Với tổng thể rất lớn hoặc không xác định (VD: “người tiêu dùng mua sắm online tại TP.HCM”), dùng công thức Cochran (1977):
n = Z² × p × (1 − p) / e² — Z = 1,96 (độ tin cậy 95%), p = 0,5 (giả định an toàn nhất), e = 0,05.
n = 1,96² × 0,5 × 0,5 / 0,05² = 384,16 → 385 quan sát.
9Chốt con số cuối cùng và viết vào luận văn
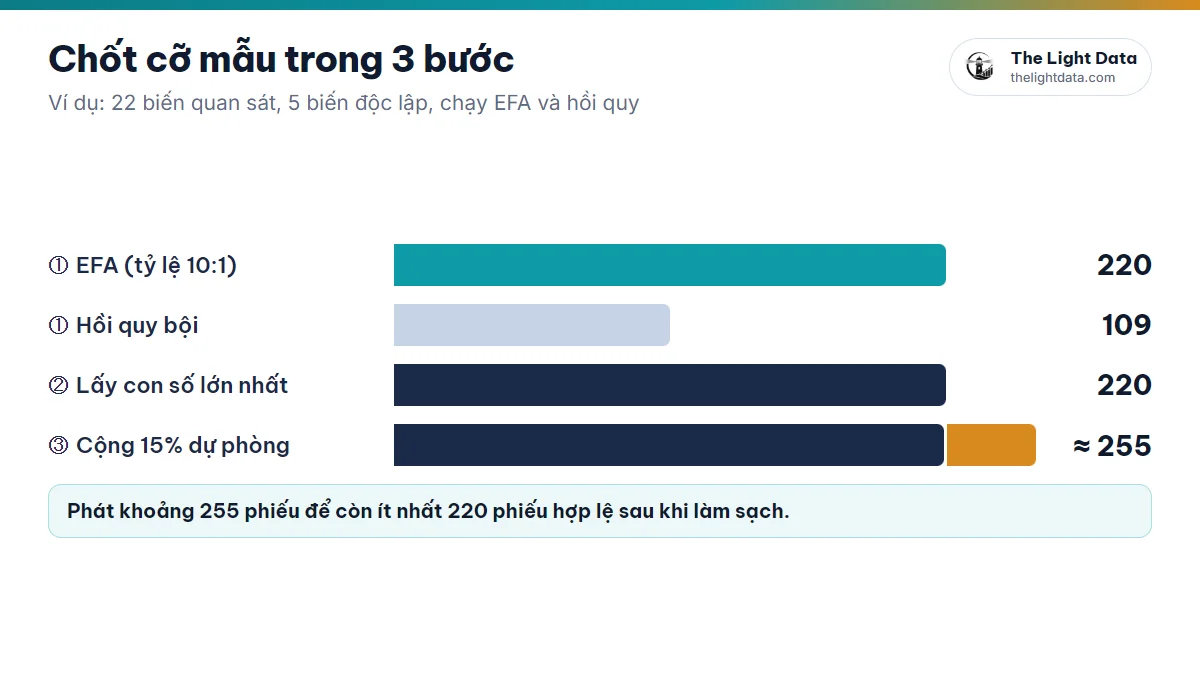
Quy trình 3 bước:
- Tính theo từng phương pháp bạn sẽ dùng.
- Lấy con số lớn nhất làm cỡ mẫu tối thiểu.
- Cộng dự phòng 10–20% cho phiếu bị loại khi làm sạch (thiếu câu, không đạt gạn lọc, trả lời một chiều).
Mô hình 5 nhân tố độc lập + 1 phụ thuộc, tổng 22 biến quan sát, chạy EFA và hồi quy:
- EFA (10:1): 22 × 10 = 220
- Hồi quy: max(50 + 8 × 5; 104 + 5) = 109
- → Cỡ mẫu tối thiểu 220, dự phòng 15% → phát khoảng 255 phiếu.
“Theo Hair et al. (2019), cỡ mẫu cho phân tích nhân tố khám phá nên đạt tỷ lệ tối thiểu 5 quan sát trên một biến đo lường, tốt hơn là 10:1. Nghiên cứu có 22 biến quan sát nên cỡ mẫu tối thiểu là 220. Đồng thời, theo Tabachnick và Fidell (2013), cỡ mẫu cho hồi quy bội với 5 biến độc lập tối thiểu là 109. Để dự phòng phiếu không hợp lệ, tác giả phát ra 255 phiếu khảo sát.”
Thiếu mẫu thì hãy mở rộng kênh khảo sát hoặc kéo dài thời gian thu thập. Dữ liệu tự tạo hay “điền cho đủ” là vi phạm liêm chính học thuật và có thể khiến luận văn bị hủy kết quả.
Chuẩn bị nhanh hơn với công cụ
- EFA: n ≥ 5–10 × số biến quan sát · Hồi quy: n ≥ 50 + 8m và 104 + m.
- AMOS: theo độ phức tạp mô hình, thường ≥ 200 · SmartPLS: (2,486 / βmin)².
- Biết tổng thể → Yamane; không biết → Cochran (≈ 385).
- Lấy con số lớn nhất, cộng 10–20% dự phòng và ghi rõ căn cứ trong luận văn.